
학습 샘플 하나, 가중치 파일 하나, 추론 호출 한 번—누가 대가를 받아야 할까요? 기존 플랫폼은 자체 장부와 종이 계약서로 답합니다. 기여자는 그것을 쉽게 검증할 수도, 강제할 수도 없습니다. 권리의 부재는 무엇보다 엔지니어링과 제도의 공백이지, 구호의 공백이 아닙니다. 이 글은 권리를 실행 가능하게 만드는 메커니즘과, Bitroot 관련 설계가 정산과 신뢰 컴퓨팅 위에 어떻게 자리 잡는지 정리합니다.
세 개의 불투명한 장부
데이터: 플랫폼에 한 번 넘긴 뒤에는 기여자가 자신의 샘플이 어떤 모델에 쓰였는지 증명하기조차 어렵고, 모델이 수익을 내도 몫을 주장하기는 더 어렵습니다. 데이터는 추적 가능한 자산이 아니라 일회용 원료가 됩니다.
모델: 파라미터와 구조는 디지털 자산이지만 공통된 권리, 라이선스, 호출 계량 체계가 없습니다. 가중치가 한곳에 있으면 외부인은 호출 수나 수익을 독립적으로 확인할 수 없고, 설계자는 플랫폼의 정산표를 받아들일 수밖에 없습니다.
수익: 플랫폼에 의지가 있어도 여전히 수동 감사와 오프라인 계약에 의존합니다—느리고 분쟁이 잦습니다. 데이터·모델·컴퓨팅 당사자에게는 작성된 대로 실행되는 공유 정산 상태 머신이 없습니다.
"온체인으로 간다"는 것만으로 이 공백이 사라지지는 않습니다. 체인은 프로그래밍 가능하고 감사 가능한 실행 환경을 제공할 뿐입니다. 신뢰 공백 지도는 Web3와 AI의 융합을 참고하세요.
플랫폼 장부에서 검증 가능한 파이프라인으로
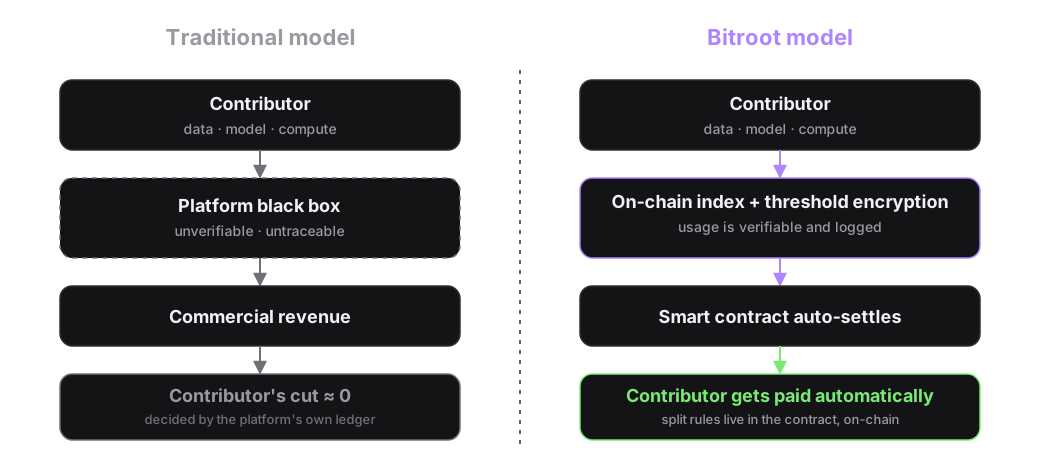
아래 다이어그램은 일방적인 플랫폼 회계와 인덱스 + 암호학 + 컨트랙트 가치 흐름이라는 직관을 대비합니다(예시일 뿐이며 금융적 약속이 아닙니다):
전체 코퍼스가 아닌 온체인 메타데이터
건전한 접근은 파일 해시, 버전, 크기, diff 다이제스트를 온체인에 등록하고, 페이로드는 탈중앙화 스토리지나 객체 스토리지에 두며, 샤드 전달과 Merkle 검증으로 다운로드 무결성을 확인하는 것입니다. 누구나 가져온 샤드가 등록 내용과 일치하는지 검증할 수 있습니다—체인이 원본 코퍼스를 보관할 필요는 없습니다. 이는 "데이터셋을 이미지처럼 민팅한다"는 것과 같지 않습니다.
접근 제어: 임계값 키 + 선택적 TEE 감사
상용 데이터와 모델에는 접근 제어가 필요합니다. 임계값 암호화 / MPC는 키를 분할해 복호화나 서명에 정족수를 요구하므로 단일 노드 탈취 위험을 줄입니다. 접근과 권한 변경은 온체인 기록을 남겨야 하며, 민감한 조각은 TEE 안에서 실행해 하드웨어 수준의 사용 감사를 받을 수 있습니다—부채널과 공급망 위험은 감수해야 합니다. 역할 분담은 신뢰 컴퓨팅 프레임워크를 참고하세요.
모델 가중치: 가져갈 수 없지만 사용할 수 있게
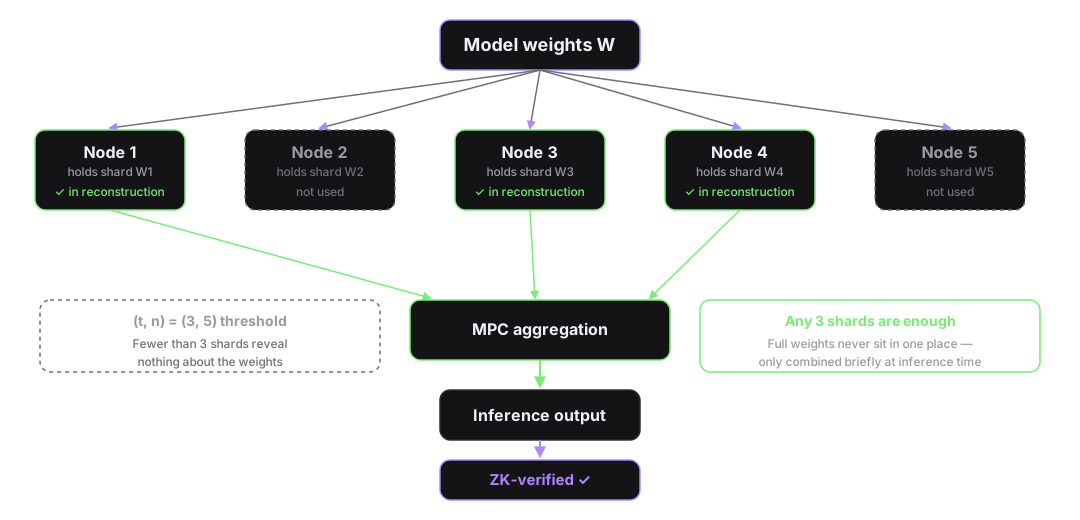
모델 자산의 어려운 문제 중 하나는 어떤 단일 상대방에게도 전체 가중치를 주지 않고 노드가 추론을 제공하게 하는 것입니다. 한 가지 엔지니어링 경로는 (t, n) 임계값 샤딩입니다. t개의 조각이 모이면 추론 결과를 집계할 수 있고, t개 미만으로는 쓸 수 있는 가중치가 나오지 않습니다. 노드는 로컬 조각으로 계산하고 MPC로 집계하며, 출력 무결성을 확인하기 위해 ZK 제약을 덧붙일 수 있습니다.
사용 권리와 완전한 소유권은 기술적으로 분리할 수 있습니다. 다만 법적 저작권과 라이선스는 여전히 계약과 관할권이 필요합니다—온체인 규칙이 모든 저작권 법령을 대체하지는 않습니다.
스마트 컨트랙트 분배: 몫을 상태 머신으로
호출이 수익을 만들면 컨트랙트는 사전 등록된 몫에 따라 지급을 트리거합니다. 데이터 기여자, 모델 설계자, 컴퓨팅 제공자가 각각 온체인 비율을 가지며 모든 정산을 감사할 수 있습니다. 이것은 규칙이 실행되는지를 답할 뿐, 비율이 공정한지는 답하지 않습니다(여전히 거버넌스와 협상의 영역입니다).
소셜 로그인 / 임계값 세션 키는 개인키 UX 장벽을 낮추지만, 보관과 복구를 MPC 참여자 집합에 노출합니다. 이 위협 모델은 명시적으로 적어야 합니다.
이것이 정산 및 컴퓨팅과 만나는 지점
권리와 지급 머신에는 예측 가능한 최종성과 충분한 처리량이 필요합니다—특히 고빈도 추론 과금과 다중 컨트랙트 분배에서 그렇습니다. 낙관적 병렬 EVM이 정산 기반일 때, 성능 수치는 테스트넷/엔지니어링 목표로 읽고 충돌 핫스팟이 병렬성을 무너뜨리는지 지켜봐야 합니다—병렬 EVM 아키텍처 개요와 성능 지표 용어집을 참고하세요. 작업 수락과 지급 인터페이스는 분산 GPU와 엣지 컴퓨팅을, 역량 경계는 AI 네이티브 블록체인을 참고하세요.
이 글은 어떤 수익률이나 투자 수익도 논의하거나 암시하지 않습니다.
흔한 설계 함정 세 가지
소유권을 표시용으로만 두고 취소/분할 전이가 없는 경우, 이의를 제기할 수 없는 계량이 과금을 다시 중앙화하는 경우, 파인튜닝과 증류에서 버전/라이선스 상속을 무시하는 경우입니다. 더 안정적인 MVP는 해시 등록 + 단순 호출별 분배 + 취소 가능한 라이선스이며, 복잡한 임계값 기법보다 분쟁 처리가 먼저 작동해야 합니다. 메커니즘 논의와 수익률 상상을 분리하세요. 마이크로페이먼트 분배에서 정산이 버티는지는 멀티 엔진 병렬 실행 설계를 참고하세요.
관할권을 넘어서면 온체인 규칙은 기껏해야 "당사자가 동의한 자동 실행 프로그램"을 제공합니다. 플랫폼 밖 복제를 없애지도, 학습 코퍼스의 침해 여부를 판정하지도 않습니다. 문서는 시스템이 보장하는 것(해시, 라이선스 이벤트, 분배 실행)과 보장하지 않는 것(전 세계적 저작권 귀속, 수익률 수준)을 밝혀야 합니다. 접근 보호는 신뢰 컴퓨팅 프레임워크, 신뢰 공백은 Web3–AI 융합을 참고하세요.
분배에 아주 작은 고빈도 결제가 많다면 계정 추상화, 배치 정산, 오프체인 채널도 평가해야 합니다. 그래야 가스와 확인 지연이 분배 몫 자체를 잠식하지 않습니다. 이는 정산 역량 위의 애플리케이션 아키텍처 선택이며, L1이 모든 분배를 보조해야 할 이유가 아닙니다. 이는 투자나 수익률 조언이 아닙니다.
계량, 취소, 분쟁: 권리의 뒷부분
해시 등록은 시작일 뿐입니다. 실행 가능한 권리에는 이중 계상을 막는 계량, 라이선스 만료나 위반 시 과금 중단, 몫 변경을 위한 멀티시그/거버넌스, 저작권 분쟁 중 감사 추적을 훼손하지 않고 흐름을 동결하는 능력도 필요합니다. 이런 상태 머신이 없으면 온체인 인덱스는 값비싼 기본 키에 불과합니다.
컴퓨팅 네트워크에 연결할 때 수락이 자동으로 "지급 가능"을 의미해서는 안 됩니다—호출자에게는 여전히 유효한 라이선스가 필요합니다. 병렬 정산 계층의 고빈도 마이크로 분배는 가스와 충돌 면을 증폭하므로, 이의 제기 가능한 상세 커밋먼트와 오프체인 집계가 필요할 수 있습니다. 충돌은 충돌 핫스팟과 워크로드를 참고하세요. 스택에서의 위치는 탈중앙화 AI 스택을 참고하세요.
프라이버시와 공개 감사의 긴장
권리는 감사 가능성을 원하고, 상용 데이터는 기밀성을 원합니다. 임계값 샤딩과 TEE가 도움이 되지만, "누구나 모든 추론을 검증"과 "가중치는 신뢰 집합을 절대 떠나지 않음"을 동시에 거의 제로 비용으로 제공할 수는 없습니다. 제품은 주된 대상(규제기관 감사, 기여자 지급 확인, 공개 검증 가능 추론)을 선택해야 하며, 각각 비용 곡선이 다릅니다.
완전한 프라이버시, 완전한 공개 검증 가능성, 거의 제로 비용을 동시에 암시하지 마세요. 정직한 계층화는 온체인 계량과 분배, 권한이 부여된 오프체인 상세, 분쟁 시 최소 증거입니다. 신뢰 컴퓨팅의 역할은 신뢰 컴퓨팅 프레임워크를 참고하세요.
핵심 요약
실행 가능한 권리에는 검증 가능한 메타데이터, 임계값 키와 가중치, 감사 가능한 접근, 자동 지급 컨트랙트가 필요합니다—그리고 이것이 신뢰 컴퓨팅 및 정산과 계층을 이룹니다. 이는 "누가 무엇을, 어떤 규칙 아래 기여했는가"를 플랫폼 블랙박스에서 검증 가능한 상태 머신으로 옮깁니다. 저작권 분쟁을 자동으로 정산하지도, 컴퓨팅 네트워크를 수익 상품으로 바꾸지도 않습니다. 관련 자료를 읽을 때는 위협 모델과 수락 흐름을 우선하세요.